Contar parece la parte sencilla de leer un estudio: localizar una cifra y compararla con otra. Sin embargo, antes de hacer una división conviene identificar qué objeto recibió cada marca. Una persona puede aparecer una sola vez en una lista de participantes y varias veces en un registro de síntomas. Si ambos documentos se resumen con la palabra casos, esa diferencia desaparece del lenguaje, aunque siga presente en los datos. Recuperarla permite preguntar por separado cuántas personas tuvieron una experiencia, cuántos episodios quedaron registrados y durante cuánto tiempo fue posible observarlos.
Esta lectura de semaglutida propone seguir el recorrido desde una fila hasta una conclusión. El gráfico conserva los datos publicados; los ejemplos que desarrollamos alrededor son ejercicios hipotéticos de conteo, sin historias clínicas reales. El objetivo es aprender a reconocer qué información sobrevive a cada resumen y cuál se pierde. Así resulta más fácil distinguir una pregunta que puede responderse con una tabla de otra que necesita registros individuales, fechas o reglas de clasificación. Leer en español también exige cuidar los sustantivos: personas, eventos y tiempo no se vuelven intercambiables por compartir un número.
Una persona puede dejar varias filas
Un registro de eventos puede organizarse como una lista en la que cada fila representa una entrada y una columna indica a quién corresponde. Contar filas responde cuántas entradas existen. Contar identificadores distintos responde cuántas personas están representadas. El segundo procedimiento exige agrupar las filas antes de sumar: cada identificador aporta una sola unidad, aunque aparezca repetido. La diferencia nace de la estructura del archivo, sin necesidad de atribuir causas, intensidades o consecuencias a las entradas.
Imaginemos un archivo hipotético con tres códigos: Alfa aparece en tres filas, Beta en una y Gamma en dos. Hay seis entradas y tres identificadores distintos. Si añadimos otra entrada de Alfa, aumenta el total de eventos, mientras el número de personas representadas permanece igual. Si la nueva entrada pertenece a Delta, ambos totales aumentan. Este pequeño ejercicio muestra por qué una misma operación de añadir una fila puede modificar dos medidas diferentes o solamente una.
También hace falta una lista separada de todas las personas incluidas en el análisis. Un archivo que contiene únicamente eventos deja fuera a quienes no tienen ninguna entrada. Por eso, contar sus identificadores distintos no permite recuperar automáticamente el tamaño completo del grupo. La tabla conceptual siguiente describe el ejemplo imaginario; no representa participantes del estudio ni establece cómo se distribuyeron sus síntomas.
Si la tabla supera el ancho de pantalla, desplázala horizontalmente. Con el teclado, enfócala y usa las flechas.
| Código ficticio | Entradas imaginarias | Aporte al recuento de personas |
|---|---|---|
| Alfa | Tres filas con el mismo identificador | Una persona distinta |
| Beta | Una fila con ese identificador | Una persona distinta |
| Gamma | Dos filas con el mismo identificador | Una persona distinta |
Fuentes: [1]
La unidad del eje decide qué se compara
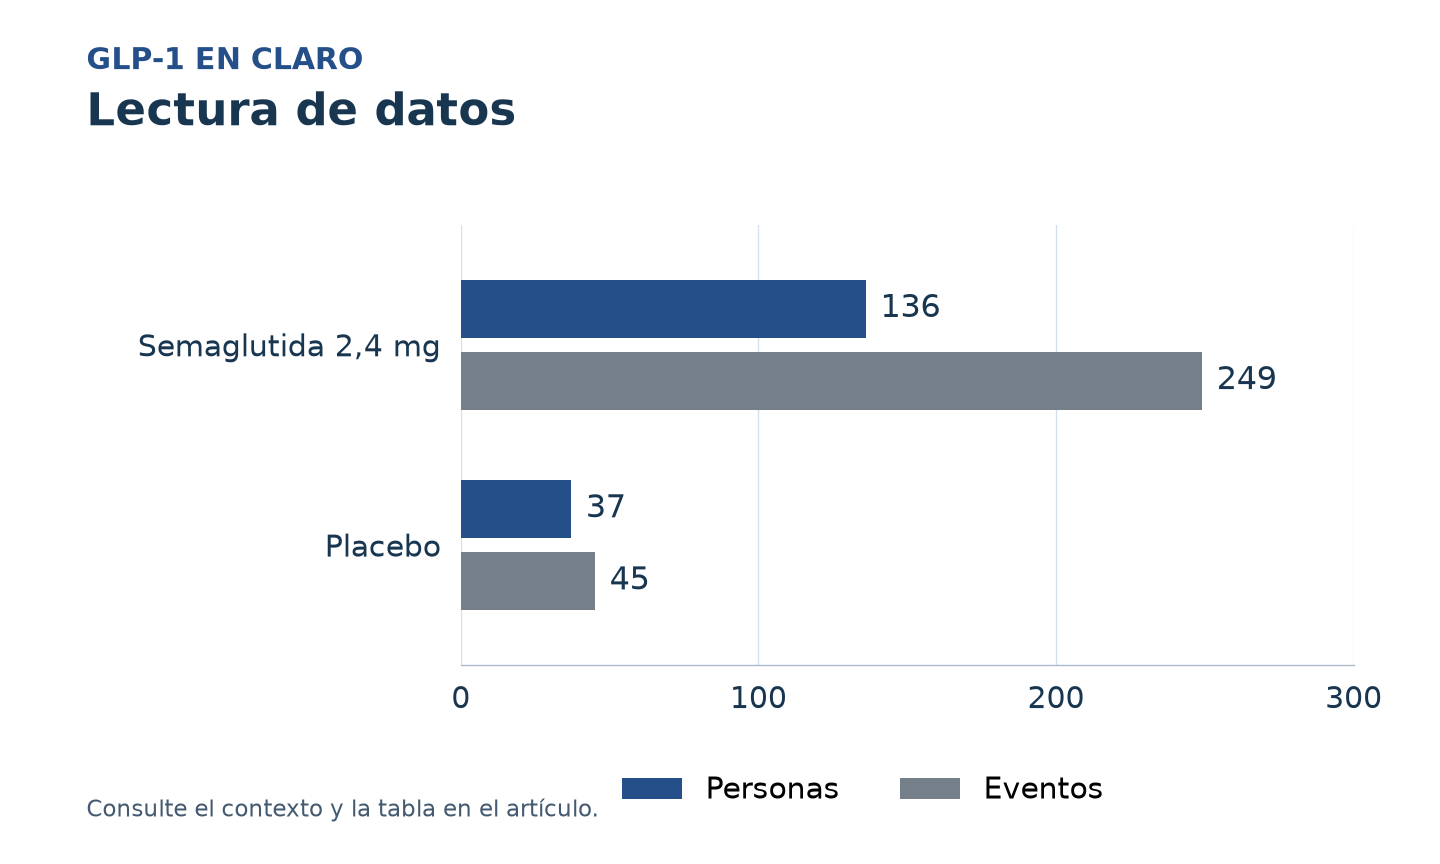
STEP 2 estudió durante 68 semanas a adultos con diabetes tipo 2 e IMC≥27. La tabla S3 cuenta náuseas durante tratamiento: última dosis en los 49 días anteriores al evento. Compara semaglutida subcutánea semanal y placebo; los denominadores corresponden al análisis de seguridad. Novo Nordisk financió el estudio.
Para leer una gráfica de recuentos, conviene recorrer primero sus etiquetas y después las longitudes de las barras. Una barra de personas y otra de eventos comparten la operación de contar, pero no el objeto contado. Su proximidad visual facilita consultar ambos resultados; no los convierte en medidas equivalentes. Tampoco transforma un eje de cantidades en una escala de probabilidades. La palabra situada junto a cada serie forma parte del significado del número y debe acompañarlo cuando se anota o se comenta.
Una lectura disciplinada puede separar dos tareas: transcribir fielmente la tabla y formular una pregunta adicional. La primera mantiene nombres, unidades y notas juntos. La segunda identifica el dato que faltaría para avanzar, en vez de rellenarlo con una suposición. Si interesa la repetición dentro de cada persona, se necesita información sobre ese reparto; si interesa la duración, hacen falta fechas. Son requisitos lógicos de las preguntas, no resultados adicionales obtenidos al observar una barra.
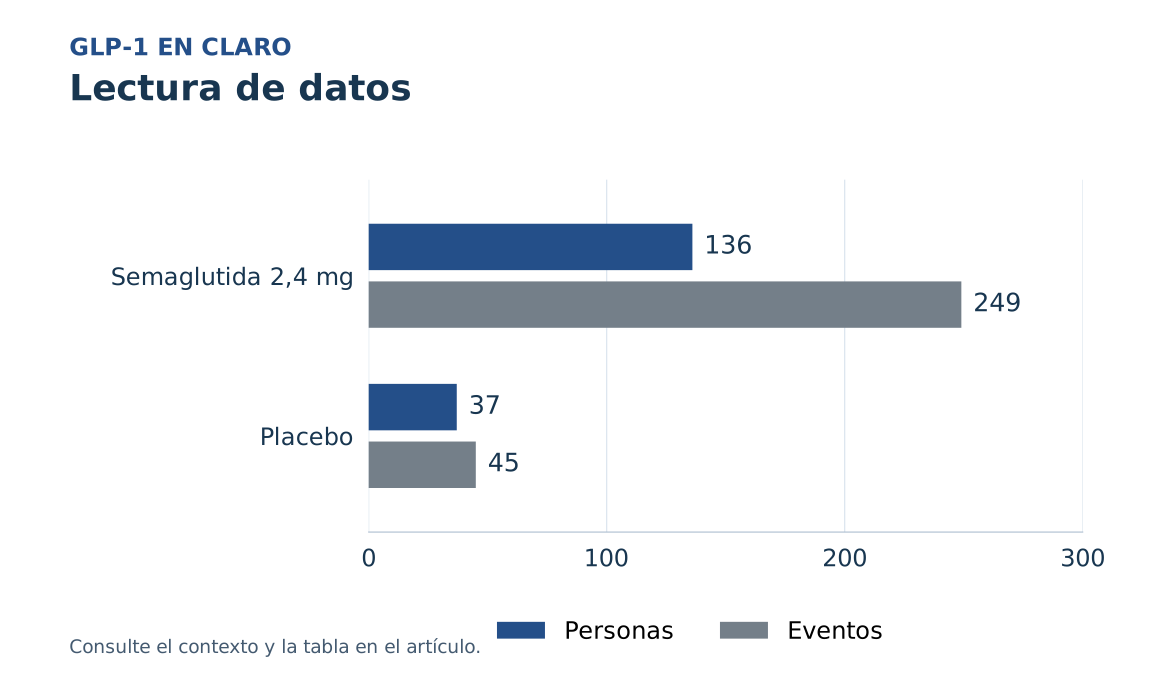
Personas y eventos de náuseas
Dos grupos seleccionados; STEP 2, tabla S3. [1]
Si la tabla supera el ancho de pantalla, desplázala horizontalmente. Con el teclado, enfócala y usa las flechas.
| Grupo | N | Personas | Eventos |
|---|---|---|---|
| Semaglutida 2,4 mg | 403 | 136 | 249 |
| Placebo | 402 | 37 | 45 |
Fuentes: [1]
Qué conserva la expresión «al menos una vez»
Una variable binaria reduce una historia a dos posibilidades: cumple el criterio o no lo cumple. Su utilidad consiste precisamente en esa simplificación. Para una pregunta sobre presencia, da el mismo peso a cada persona y evita que quien tiene muchas entradas domine el recuento. Pero esa decisión descarta información. Una vez convertido todo a sí o no, ya no se distingue una experiencia aislada de una secuencia de experiencias, salvo que otra variable conserve esa diferencia.
Consideremos dos grupos hipotéticos de diez personas, observados durante el mismo período completo. En cada grupo, cuatro personas presentan el evento imaginario. En el primero, cada una tiene una entrada; en el segundo, cada una tiene tres. Ambos grupos producen cuatro marcas positivas, aunque sus registros contienen cuatro y doce eventos, respectivamente. La coincidencia del resumen binario no prueba que las historias sean iguales: demuestra únicamente que satisfacen el mismo criterio de presencia.
La elección depende de lo que se quiera conocer. Una pregunta sobre extensión entre personas necesita conservar la identidad; otra sobre cantidad de episodios necesita conservar la multiplicidad. También puede cambiar la definición de aquello que activa la marca. La guía sobre desenlaces compuestos desarrolla esa cuestión de clasificación. Antes de comparar porcentajes, conviene comprobar tanto la unidad contada como la regla que permite incluirla, porque cada decisión modifica el significado de la respuesta.
Fuentes: [1]
Restar eventos y personas no identifica la recurrencia
Podemos demostrar el problema con dos distribuciones hipotéticas. Cuatro personas acumulan ocho eventos. En una distribución, la primera tiene cinco y las otras tres tienen uno cada una. En otra distribución, cada persona tiene dos. Los totales de personas afectadas y de eventos coinciden, pero solamente una persona repite en la primera distribución y las cuatro repiten en la segunda. La misma resta entre totales es compatible con respuestas distintas a la pregunta sobre cuántas personas tuvieron recurrencia.
La resta sí tiene una interpretación aritmética bajo las condiciones del ejemplo hipotético: cuenta las entradas que quedan después de reservar una para cada persona representada. Esas entradas adicionales pueden concentrarse o repartirse. Para convertirlas en personas con repetición habría que saber cuáles comparten identificador. Asignar cada entrada sobrante a una persona diferente añade una hipótesis que no viene incluida en los totales. Asignarlas todas a la misma persona añade otra, igualmente invisible en el resumen.
Este es un problema de identificación: la información disponible admite varias historias compatibles. Una división más elaborada no selecciona por sí sola la historia verdadera. La solución requiere publicar otra medida, como la distribución de personas por número de eventos, o consultar registros enlazados. Esa distinción evita confundir una respuesta calculable con una respuesta determinada por los datos. La aritmética puede ser impecable y, aun así, estar contestando una pregunta distinta de la que se formuló.
Fuentes: [1]
Tres denominadores producen tres preguntas
En un ejemplo hipotético separado, un grupo de diez personas tiene cuatro personas con registros y ocho eventos en total. Dividir ocho entre diez produce 0,8 eventos por persona del grupo, incluyendo a quienes no registraron ninguno. Dividir ocho entre cuatro produce dos eventos por persona afectada. Dividir cuatro entre diez produce una proporción de 0,4, equivalente al 40 %. Los tres cálculos son correctos y describen aspectos diferentes del mismo archivo imaginario.
La unidad del resultado revela la diferencia. Eventos por persona sigue siendo una media de recuentos; una proporción de personas utiliza personas tanto arriba como abajo. Además, seleccionar únicamente a quienes tuvieron algún evento cambia el conjunto sobre el que se promedia. Esa media condicionada no informa directamente de la probabilidad de repetir. Para calcular una proporción de recurrencia habría que definir el grupo de referencia y contar qué personas cumplen el criterio de repetición, en lugar de sumar sus entradas.
Es útil escribir la fracción con palabras antes de sustituir cantidades: eventos divididos entre personas afectadas, por ejemplo. Esa línea funciona como una etiqueta de unidades y permite detectar cambios silenciosos de denominador. Después aparece otra decisión, la cantidad de decimales que se mostrará. La lectura sobre precisión de porcentajes y tirzepatida aborda ese paso de presentación. Conservar más cifras decimales nunca corrige haber elegido una fracción que responde a otra pregunta.
El tiempo de observación también necesita contarse
Imaginemos otro seguimiento hipotético: tres personas aportan cuatro, dos y una semanas observadas, respectivamente. Si todos esos intervalos son válidos para contar el evento definido, suman siete personas-semana. Supongamos que durante ellos se registran siete eventos. El cociente es un evento por persona-semana. No significa que cada persona tuviera un evento cada semana, ni informa de cuántas personas tuvieron alguno. Es una relación entre un total de entradas y un total de tiempo acumulado.
El tiempo acumulado permite describir la cantidad registrada en relación con la observación disponible. Sin embargo, sumar intervalos no elimina todas las diferencias entre historias. En un diseño hipotético, los eventos podrían concentrarse al principio del seguimiento o los períodos más cortos podrían corresponder a personas con características distintas. Una tasa resumida necesita interpretarse con esas posibilidades presentes. Estandarizar la unidad de tiempo no equivale a demostrar que la oportunidad de observar o el proceso subyacente fueron comparables.
Para construir el denominador temporal hay que fijar un comienzo, un final y las reglas sobre interrupciones. No basta multiplicar el tamaño del grupo por una duración anunciada sin comprobar qué tiempo aportó cada persona. Cuando una historia termina antes de lo previsto, importa tanto cuánto tiempo deja de observarse como por qué termina. La guía de datos faltantes y abandono permite continuar esa pregunta sin tratar la ausencia de observación como si fuera una observación sin eventos.
Fuentes: [1]
Varias entradas pueden compartir una misma historia
En un archivo hipotético, cinco filas podrían proceder de una persona o de cinco personas diferentes. El número de filas sería idéntico, pero la estructura que las relaciona cambiaría. Cuando varias entradas pertenecen al mismo individuo, comparten parte de su historia y de su observación. No corresponde asumir que cada fila aporta una persona independiente. El identificador sirve, por tanto, para algo más que evitar duplicados: conserva la agrupación necesaria para interpretar la información.
Esta distinción importa al pensar en la incertidumbre. Añadir una entrada de alguien ya observado amplía el detalle de su trayectoria, pero no añade automáticamente otra trayectoria independiente. La información nueva puede ser valiosa para estudiar repetición, secuencia o duración. Su valor no se resume contando filas como si todas fueran individuos distintos. Cualquier análisis que cuantifique incertidumbre necesita decidir cómo representar esas relaciones, en vez de deducir su precisión únicamente del tamaño aparente del registro.
Tampoco se puede concluir que todas las entradas de una persona sean idénticas o que siempre exista una relación de intensidad determinada entre ellas. La idea más limitada es que su dependencia requiere consideración. En términos de organización, conviene conservar dos niveles: un registro de personas y otro de eventos vinculados a ellas. Esa separación permite elegir posteriormente una pregunta sobre individuos, sobre trayectorias o sobre episodios sin perder el vínculo que distingue esos niveles.
Fuentes: [1]
Cada episodio necesita un principio y un final definidos
Antes de contar episodios hay que decidir qué hace que una entrada sea nueva. Como ejemplo hipotético, una anotación inicial y una actualización posterior podrían describir la misma experiencia todavía abierta. Contarlas como dos episodios cambiaría el resultado por una decisión administrativa. En cambio, fusionar experiencias separadas borraría una repetición. La fecha de captura del formulario y la fecha de inicio del evento cumplen funciones diferentes; conservar ambas ayuda a interpretar una modificación sin inventar otro comienzo.
Un diccionario de datos puede especificar qué significa inicio, cómo se documenta el final y qué criterio distingue un nuevo episodio de la continuidad del anterior. También debe diferenciar una corrección de un registro adicional y una fecha desconocida de una ausencia confirmada. Estas son preguntas generales para diseñar o leer registros; no implican que un estudio concreto haya cometido esos errores. Hacen visible una decisión que el número final, aislado de su documentación, no puede explicar.
La consistencia exige aplicar las mismas reglas a todas las entradas que se pretende comparar. Si cambia la definición a mitad del archivo, la comparación necesita reconocer ese cambio. La guía para comparar estudios GLP-1 ofrece una continuación sobre preguntas y medidas comparables. El primer control no consiste en buscar cifras parecidas, sino en comprobar si los sustantivos y las reglas que producen esas cifras significan lo mismo en cada contexto.
Fuentes: [1]
Una tabla más informativa conserva los vínculos
Un total por columna se llama marginal porque resume una característica sin conservar necesariamente su relación con las demás. Saber cuántas personas registraron un evento y cuánto tiempo se observó al conjunto no revela quién aportó cada intervalo. Para estudiar esa relación haría falta cruzar ambas dimensiones. La diferencia entre disponer de varios totales y disponer de datos enlazados es crucial: muchas preguntas se refieren precisamente a combinaciones que desaparecen al sumar cada columna por separado.
Pensemos en dos archivos hipotéticos con igual número de personas afectadas e idéntico tiempo total observado. En uno, las personas con eventos concentran los intervalos largos; en el otro, concentran los cortos. Los márgenes coinciden, pero la relación entre observación y presencia cambia. Este ejemplo no prueba que exista tal patrón en una investigación. Muestra por qué los totales separados no bastan para afirmar que no existe, ni para reconstruir cuál habría sido su dirección.
La tabla conceptual propone campos útiles para mantener abiertas esas preguntas. No es una solicitud de publicar identidades personales: un identificador interno puede permitir enlaces sin incluir nombres en una tabla analítica. También cabe publicar distribuciones agregadas cuidadosamente definidas. Lo importante es especificar qué información conserva cada producto. Si solo se dispone de un resumen, la interpretación debe detenerse en las relaciones que ese resumen identifica, dejando las demás como preguntas que requieren otra estructura de datos.
Si la tabla supera el ancho de pantalla, desplázala horizontalmente. Con el teclado, enfócala y usa las flechas.
| Campo propuesto | Qué conserva | Pregunta que permite formular |
|---|---|---|
| Identificador de persona | El vínculo entre entradas del mismo individuo | Qué registros pertenecen a una misma trayectoria |
| Identificador de evento | La diferencia entre episodio y actualización | Si una modificación añade un episodio distinto |
| Inicio y final observados | Los límites temporales de cada registro | Qué duración puede calcularse con fechas conocidas |
| Intervalos de seguimiento | El tiempo válido aportado por cada persona | Cuánta observación corresponde al grupo analizado |
| Motivo del cierre | La razón documentada para terminar la observación | Qué información queda desconocida después del cierre |
Fuentes: [1]
Llevar una pregunta bien definida a la conversación
La etiqueta de Wegovy advierte sobre reacciones gastrointestinales graves y lesión renal asociada a deshidratación. No recomienda su uso en gastroparesia grave. Ante síntomas gastrointestinales graves o persistentes, indica contactar al profesional de salud. La FDA no aprueba los preparados compuestos ni revisa su seguridad, eficacia y calidad antes de comercializarlos.
Al conversar sobre una cifra, una pregunta útil identifica primero el objeto: ¿se están contando personas distintas o entradas repetidas? Después puede pedir la regla temporal y el denominador. Esa secuencia permite reconocer cuándo una respuesta está cambiando de pregunta sin advertirlo. Para ordenar la documentación sobre identidad del producto, puede consultarse la guía de farmacias y formulaciones. La precisión en los términos ayuda a mantener separadas una lectura estadística y una decisión clínica personal.
Las condiciones de un servicio requieren otra lectura documental. Se pueden consultar las reseñas de CoreAge Rx y de Ro, atendiendo a sus fechas, documentos y preguntas pendientes. Esos enlaces no funcionan como denominadores ni completan historias individuales de un estudio. La disciplina es la misma que al leer una tabla: localizar qué afirmación se quiere verificar, qué documento podría responderla y qué información sigue faltando, sin convertir una medida colectiva en una promesa sobre una persona.
Preguntas frecuentes
¿Un registro vacío demuestra que no hubo síntomas?
Solo si el sistema permite distinguir una observación completa sin eventos de una observación ausente. Un campo vacío puede representar información desconocida, mientras un cero documentado representa una respuesta concreta bajo ciertas reglas. Antes de combinarlos, conviene conocer cómo se definieron ambos estados y si todas las personas tuvieron oportunidad comparable de aportar información.
Fuentes: [1]
¿Un promedio de eventos describe a la persona típica?
Una media resume el total dividido entre un grupo definido, pero no identifica una historia individual. Distintas distribuciones pueden producirla. Para describir la variación entre personas hacen falta otras medidas o una distribución de recuentos. También debe aclararse si el promedio incluye a quienes no tuvieron eventos o solamente a quienes registraron alguno.
Fuentes: [1]
¿Basta conocer cuántas personas repitieron para entender la carga total?
Ese dato responde una pregunta útil, pero todavía comprime las historias de quienes repitieron. No distingue cuántos episodios tuvo cada persona, cuánto duraron ni cómo se distribuyeron en el tiempo. La medida adecuada depende de la pregunta concreta; añadir un indicador no sustituye automáticamente a todas las dimensiones que quedaron fuera.
Fuentes: [1]
¿Se pueden sumar categorías de síntomas para obtener personas afectadas?
La suma solo coincide con un recuento de personas distintas cuando las categorías no comparten personas y cubren exactamente el conjunto que interesa. Si alguien aparece en varias, sumar sus tamaños cuenta esa identidad más de una vez. Para obtener la unión se necesita conocer los solapamientos o trabajar con identificadores que permitan deduplicar.
Fuentes: [1]
¿Qué conviene guardar al anotar una cifra de una tabla?
Además del número, conviene anotar la unidad, el nombre de la columna, el grupo de referencia y la regla temporal que lo acompaña. La ubicación de la tabla permite volver a comprobar sus notas. Una cifra separada de esas etiquetas puede seguir siendo exacta como transcripción y, sin embargo, perder el significado necesario para interpretarla.
Fuentes: [1]
La pregunta que conviene conservar
La lectura más útil conserva la estructura que produjo el resultado. Primero identifica personas y entradas; luego pregunta qué información se pierde al resumirlas, qué denominador responde al propósito elegido y cómo se contabilizó la observación. Ese recorrido permite reconocer una limitación sin convertirla en una acusación contra los datos. Un resumen puede responder correctamente a una pregunta y dejar otra sin resolver. Frente a esa segunda pregunta, el siguiente paso es identificar la información necesaria: una distribución de recuentos, fechas, reglas de cierre o vínculos entre registros. La calidad de la interpretación depende de mantener esa correspondencia entre pregunta y dato, especialmente cuando una cifra breve parece ofrecer más respuestas de las que realmente contiene.
Fuentes y límites de esta lectura
- Wharton 2022, tabla S3.
- Rubino 2025, tabla S1.
- Wegovy: etiqueta vigente.
- Zepbound: etiqueta vigente.
- FDA: preparados no aprobados.
Los ejercicios numéricos son hipotéticos y no reconstruyen historias individuales. Esta lectura metodológica no estima una probabilidad personal, no compara servicios por resultados clínicos y no sustituye una evaluación profesional. Los enlaces documentales permiten consultar otros temas; sus títulos no amplían lo que puede deducirse del gráfico.